我给了 AI 一个能动手的接口:白名单、二次确认、审计日志,一个都不能少
起因:能看,不等于能修
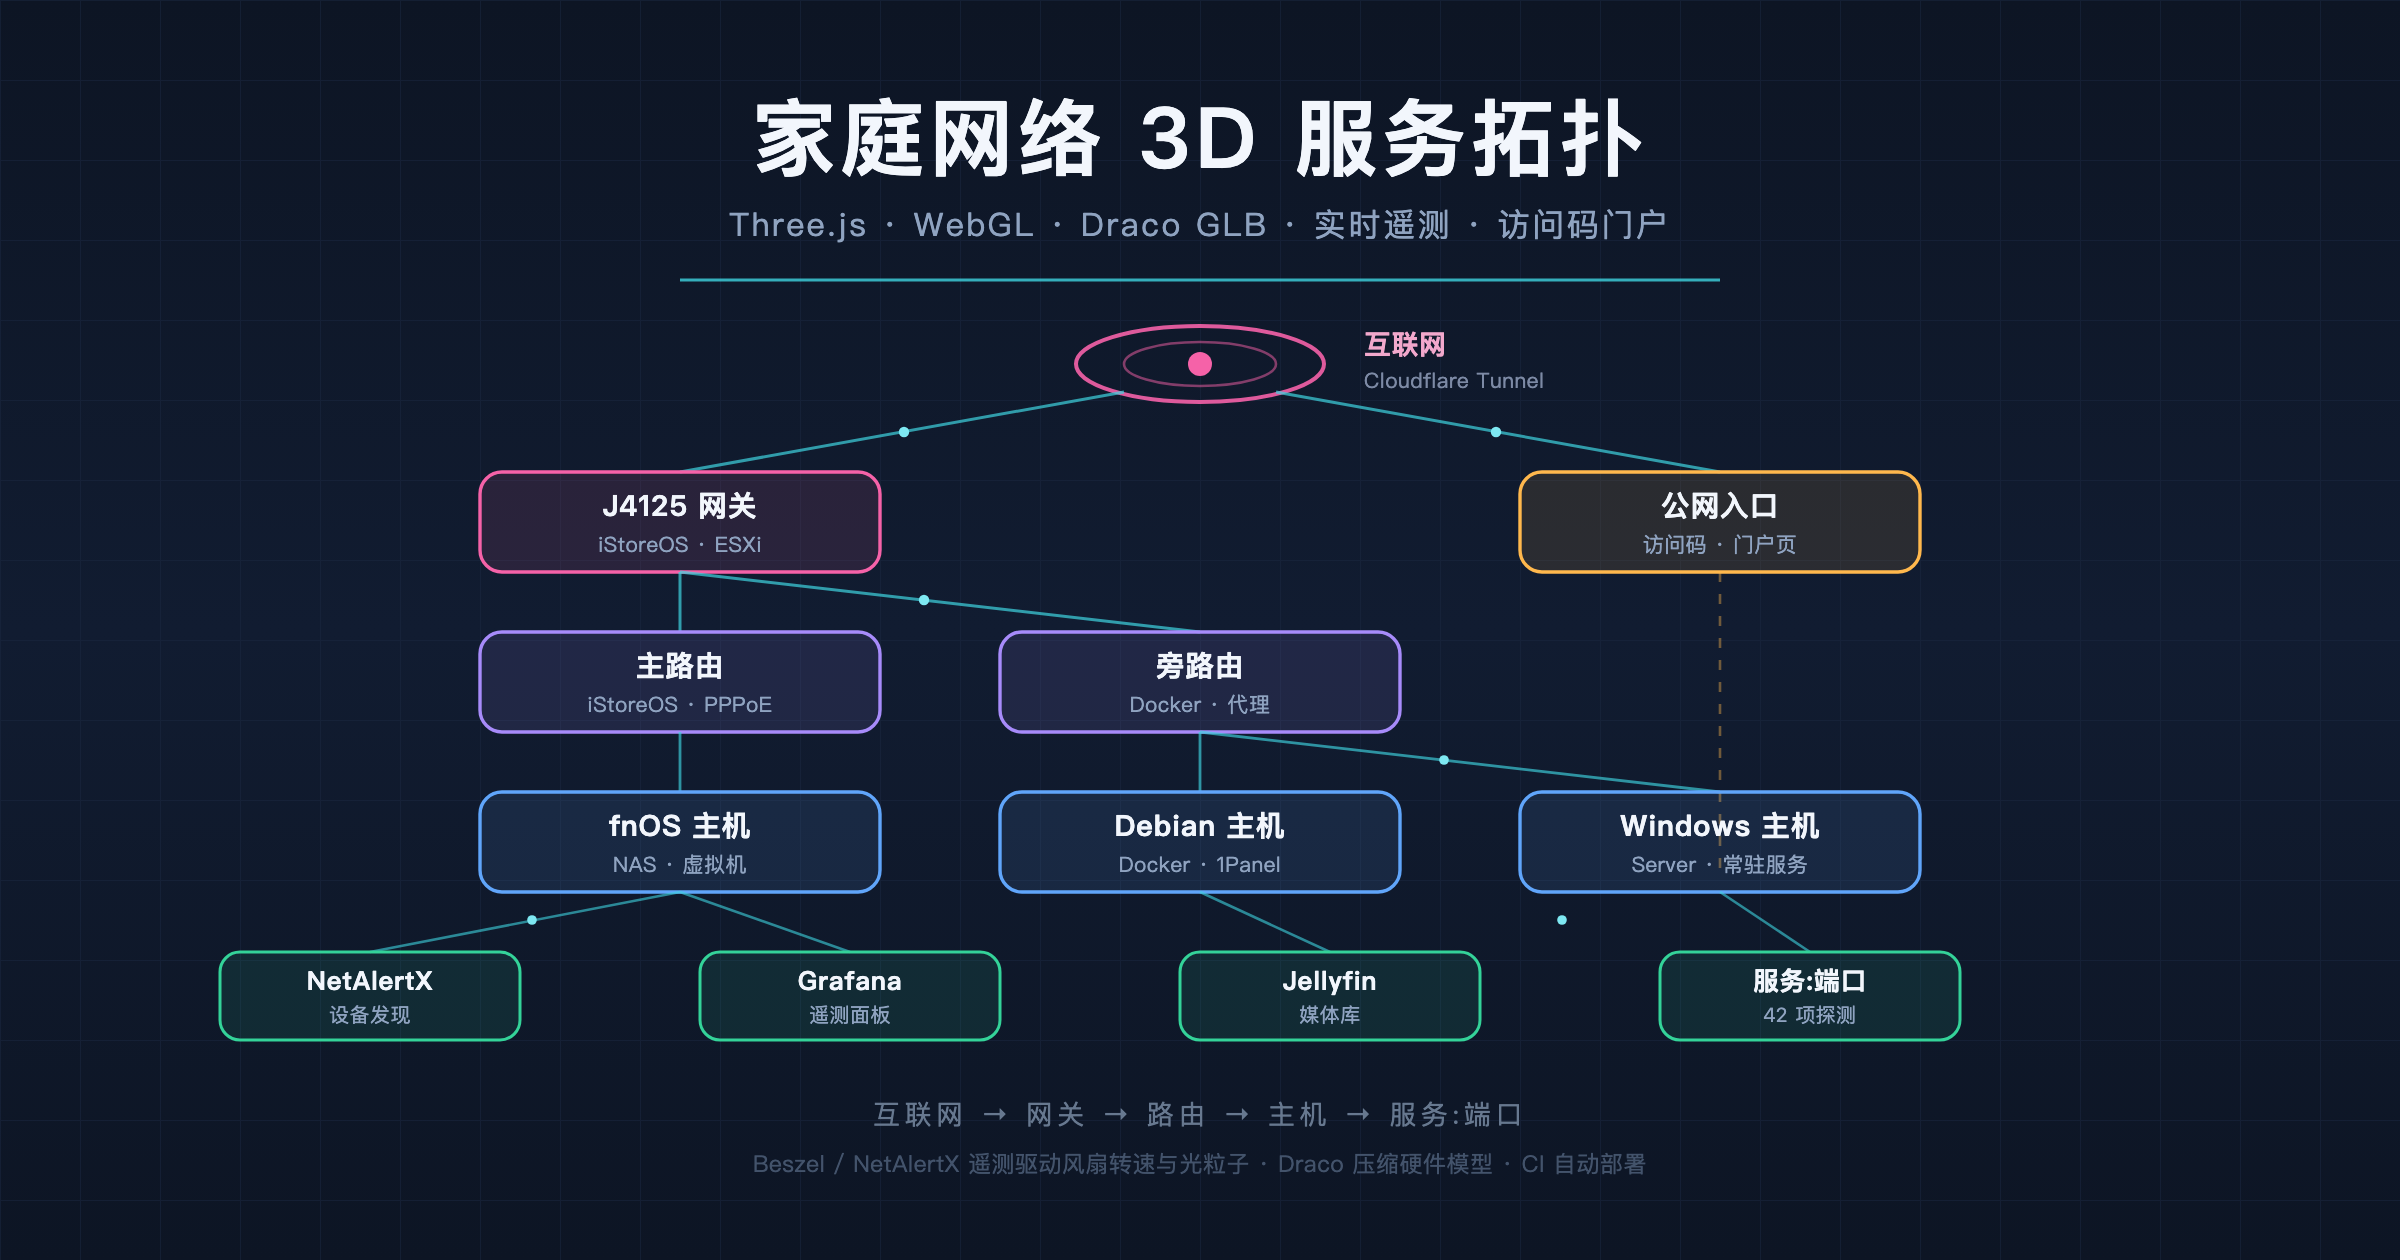
我给家里的服务器做了一套巡检:13 个服务,每 10 分钟探一次,挂了就推手机。
用了一个月,发现问题不在”发现”,在”之后”。
手机上收到「Immich 不可达」,我点开看一眼,然后呢?要么去开电脑,要么假装没看见。AI 助手那边更尴尬——我问它”家里怎么样”,它能准确报出「13/13 个服务在线」;我问它”Immich 为什么挂了”,它只能说”当前是正常的”。
它看得见状态,但看不见原因,也伸不出手。
所以这一轮的目标很明确:给 AI 一个能动手的接口。但”能动手”三个字很危险——一个能执行 docker 的 AI,等于把服务器 root 交给一个会幻觉的模型。
这篇文章记录的就是这个矛盾怎么解:既要让它真的能修,又要保证它修不坏。
一、先把边界画出来
动手之前先定四条规矩,后面所有设计都是从这四条长出来的。
第一条:一个入口,不是五个。
AI 那边每加一个能力,就要新建一个「自定义连接器 + API 密钥」。加到第三个的时候我已经开始配错了——密钥填错、URL 少一段、方法写成 GET。
所以把读、写、推、记全部收进一个端点,用 intent 区分:
1 | POST https://<你的域名>/webhook/muse |
一个 URL,一个令牌,能力全在里面。
第二条:读和写分开限速。
读很便宜,而且 agent 会反复问(”现在呢?””那 immich 呢?”)。如果读写共用一个 6 次/5 分钟的桶,正常对话会被自己卡住。
所以分两个桶:读 60 次/5 分钟,写 6 次/5 分钟。写要防的是 agent 循环重启,那个必须收紧。
第三条:白名单写在文件里,不写在代码里。
1 | # /opt/muse-jobs/actions.conf |
名单里刻意不含 n8n、cloudflared、nginx、vaultwarden 和各数据库——重启它们等于把调用方自己也弄死。
第四条:能改状态的操作,一律两步。
这条是整篇文章的重点,下面单独讲。
二、从”能看”到”能查”:单服务钻取
原来问”immich 还好吗”,AI 只能回一句”13/13 正常”。这句话没错,但没用——13 个里有一个半死不活它也这么说。
所以加了一个 service——一次把散在六个地方的数据拼成一张画像:
1 | {"intent": "service", "name": "mealie"} |
1 | { |
数据来自:docker inspect、探针、timeline、updates.json、git 记录、日志签名表。实测 2.9 秒。
这里最要紧的是最后那个 missing 字段。
查不到的项明确列出来,而不是省略。因为 agent 很擅长脑补——你不给它 missing,它就会把”没查到”说成”没有问题”。
我给它写的规则是:
service 返回里的 missing 表示「这项查不到」,必须如实说查不到,不要猜。
它照着做了。有一次日志签名查不到,它的回复是:
日志错误签名这一项没拿到。原因不是”确认没有报错”,是这一项暂时查不到。
这句话比我写过的所有 prompt 都值。
三、能动手,但不能自己决定:两步升级
这是整个设计里我花了最多心思的地方。
最直接的做法是给它一个 upgrade,它调一下,容器就升了。但我不敢——模型会幻觉,容器会起不来,而我可能在睡觉。
所以做成两步。
第一步:只出计划
1 | {"intent": "upgrade", "name": "it-tools"} |
返回:
1 | { |
这一步什么都不动。 它只是把”我打算做什么”写清楚,附上回滚命令,然后给一个 10 分钟内有效的确认码。
第二步:带码才执行
1 | {"intent": "upgrade", "confirm": "b110c5"} |
这时候才真的 pull + up -d。执行完检查容器状态,没起来就推一条 priority=4 的告警,并把回滚命令一起发给你。
实测一次:
1 | [pull] ok it-tools Pulling / Pulled |
有意思的是这次镜像 ID 没变(镜像源返回的是同一摘要),所以 compose 判定”无需重建”,容器 uptime 一直没断。
这恰好证明了一件重要的事:它不会做无谓的重启。如果是”无脑 pull + 强制 recreate”的写法,这次就会白重启一次。
为什么”两步”比”确认按钮”更好
我本来想的是”执行前弹个确认”。但 agent 不是图形界面——你和它的交互是对话,不是点击。
用两次请求换一次确认,好处是:
- 计划可以先给你看,你会看到回滚命令。看到回滚命令的那一刻,你对这次操作的信任度是不一样的
- 过期机制天然存在(10 分钟),不用额外设计
- 审计日志能完整记录「谁在什么时候申请了什么,谁在什么时候批了」
日志里长这样:
1 | 01:02:31 DENY upgrade confirm=zzzzzz 无匹配计划 |
中间那条 PLAN 是”申请”,最后那条是”执行”。申请和执行分开了,责任就分开了。
四、还有一个我没想到的需求:让它闭嘴
接口做完没两天,我收到了一条推送,内容是”这条不该到你手机”——我自己写的测试。
但这暴露了一个真实场景:运维时手机被自己的告警轰炸。你在重启 n8n,告警当然满天飞,你全都知道,全都想忽略。
所以加了 mute:
1 | {"intent": "mute", "minutes": 60} |
静音状态写在一个文件里,三处读同一份:
- 所有定时任务(Python,直接读文件)
- 统一入口自己(
say/remember) - 探针(n8n 读不了本地文件,所以走 HTTP 从静态服务读)
两个刻意的设计:
1. say 不受静音影响。 你明确让它说一句,那不算噪音。技术上就是 force=True 绕过闸门。
2. 读不到文件就当没静音。 文件缺失、JSON 坏了、until 不是数字——一律按”没静音”处理。
第二点很重要:静音是个”少做事”的功能,它的失败方向必须是”多推一条”,而不是”静默失效”。否则某天文件写坏了,你会以为家里一切正常,实际上是所有通知都被吞了。
五、五个真踩过的坑
1. n8n 的 publish:workflow 不会注册 webhook
现象:工作流 active=1,数据库里也看得到,但公网访问永远 404 not registered。
原因:CLI 的 publish 只写了 workflow_entity.active,没有写 webhook_entity,也没有设 triggerCount。n8n 启动时看 triggerCount=0 就跳过注册。
最后是停库、手写 webhook_entity 行、把 triggerCount 设成 1 才生效。
结论:新建 webhook 工作流请在 UI 里点 Active,别信 CLI。
2. Respond to Webhook 的状态码在 options 里
1 | // 错:静默返回 200 |
写错位置不会报错,只会让你以为 401 生效了,其实一直是 200。
3. grep -r /opt 要找 117 秒
我要在 compose 文件里找某个服务,第一版写了 grep -rl mealie /opt。
实测:117 秒,而且第一个命中的是 git 工作树里的副本(因为我把配置同步到了 /opt/muse-git/work),拿到的路径是错的。
改成直接读文件后:2.9 秒,结果准确。
4. Python 写文件是块缓冲
run_job 是异步执行任务的,job_status 用来查进度。但加完发现:任务跑完之前,日志永远是空的。
原因:subprocess.Popen 起子进程时,Python 的输出是块缓冲的,不到 4KB 不落盘。
改成 python3 -u 就好了。
5. /tmp 有 fs.protected_regular
root 覆盖不了别的用户在 /tmp 创建的文件:
1 | curl: (23) client returned ERROR on write |
第一次遇到时我以为是磁盘满,查了半天 df。
后来所有临时文件都放 /root/ 下面,不再用 /tmp。
六、现在的效果
三个真实对话:
“家里现在怎么样”
13 个服务全在线,全部正常,没有异常,也没有任何服务掉线。最慢的一个响应 334 毫秒。
“immich 还好吗”
容器状态:拿到了……刚刚实时测了一下,现在可达,响应 243 毫秒。镜像有新版本了,升不升你说了算,我没有动它。
“测一下网速”
先说清楚口径:这组数字是代理链路的带宽,不是你家宽带的真实带宽。测速服务器落在 CMHK/香港,说明出口在境外、走了代理,所以别拿这个数去判断运营商给了多少。
下载 4.2 Mbps,上传 4.1 Mbps,延迟 13.7 毫秒,丢包 3.69%。丢包这个偏高,视频通话和游戏会明显感觉到卡。
最后一条里,“先说清楚口径”是我在指令里要求的——因为第一次测出来 4 Mbps 时,我自己都以为运营商只给了 4M,实际是代理链路的问题。
七、复盘:什么该给 AI,什么不该
做完这一轮,我的判断标准变成三个问题:
1. 它做错了,后果可逆吗?
重启容器可逆(再起一次),删数据不可逆。所以 restart 给,rm 永远不给。
2. 它能不能在动手前把计划说清楚?
能,就说明这个操作是可解释的,可以做两步确认。说不清楚的操作(”优化一下性能”)就不该开放。
3. 出问题时,我能不能在 3 分钟内查清它做了什么?
靠审计日志。每个请求都记:谁、什么时候、想做什么、结果如何。没这条,前面两条都是空话。
按这三条筛,最后开放出去的其实很少:看状态、查单服务、跑只读任务、重启白名单容器、两步升级、推送、记日记。
但已经够用了。它现在能做的事,覆盖了我 80% 的”看一眼”需求,和 100% 的”重启一下试试”。
剩下的 20%,本来也需要我自己去看。
相关代码(全部在本机跑,不上云):
actiond.py— 统一入口,stdlib 实现,无框架common.py— 静音闸门、推送、状态- n8n 工作流 — 探针、早报回传、历史追问
如果你也想给自己搭一套,我建议从最没用的那个能力开始——先做 status,跑一周,看看 agent 会怎么问、会怎么误解。你对它的信任边界,是在这些误解里长出来的,不是在设计文档里。